AlphaGenome, la IA aplicada a desvelar el genoma y sus miles de variantes
En enero de este año, la revista Nature publicó el trabajo Advancing regulatory variant effect prediction with AlphaGenome1, en el que se presentaba la nueva herramienta y plataforma biocomputacional AlphaGenome, desarrollada con técnicas de Inteligencia Artíficial (IA) por la empresa Google DeepMind, bajo el liderazgo de Pushmeet Kohli y Demis Hassabis. AlphaGenome ha llamado mucho la atención del mundo científico, ya que DeepMind ya se había convertido en una referencia en IA aplicada a la biología gracias a AlphaFold2, el algoritmo computacional que revolucionó la predicción de la estructura tridimensional de las proteínas a partir de su secuencia aminoacídica. Por este trabajo, Demis Hassabis y John Jumper, de Google DeepMind, obtuvieron el Premio Nobel de Química en 2024, compartido con el profesor David Baker de la Universidad de Washington. En el citado artículo de Avsec y colaboradores, AlphaGenome se presenta como un nuevo modelo de Deep Learning unificado y multimodal, diseñado a modo de herramienta predictiva para estimar cómo cada variante genética dentro de la secuencia del DNA puede interpretarse funcionalmente tras ser asociada a múltiples y complejas señales moleculares del genoma. Desde esta perspectiva, cada variante deja de entenderse únicamente como una coordenada genómica y una simple secuencia de nucleótidos (GATACA…), para pasar a interpretarse como una posible clave de activación y control de un mecanismo biológico funcional concreto.
El efecto de la IA sobre el estudio del genoma humano global
Hasta ahora, interpretar el efecto de una variante en la secuencia genómica solía exigir combinar herramientas distintas, cada una entrenada para un tipo de señal biológica concreta, resultando en predicciones muy variables, poco precisas y altamente cuestionables. AlphaGenome propone evaluar una misma alteración o variante en la secuencia del DNA desde una multiplicidad de niveles de anotación y de información genética de manera simultánea. Además, dicha variante es comparada al mismo tiempo con miles de predicciones de secuencias del mismo genoma, contrastadas entre sí y dependiendo de su convergencia apuntan hacia mecanismos biológicamente más o menos plausibles. De este modo, AlphaGenome toma un enfoque genómico global: holístico. Esta capacidad puede ser muy útil en varios campos. Así, en estudios de asociación genómica, puede ayudar a ordenar variantes candidatas atendiendo no sólo a su localización o conservación, sino a su posible impacto molecular en un tipo celular determinado. De modo similar, en el diseño de experimentos funcionales sobre regiones del genoma en los que se concentran datos de asociación derivados de Genome-Wide Association Studies (GWAS, por sus siglas en inglés), AlphaGenome ayuda a seleccionar y priorizar las variantes para su validación empírica, facilitando información sobre el gen afectado, el tejido implicado o el mecanismo de regulación génica más probablemente alterado. También, como otro ejemplo, en el análisis de QTLs reguladores (eQTL, sQTL, caQTL o bQTL), AlphaGenome añade a los resultados estadísticos de cada tipo de QTL una posible explicación de cómo podrían funcionar esos efectos reguladores a nivel biomolecular.
El motor de AlphaGenome: una mirada a su arquitectura
La herramienta pertenece a la familia de modelos sequence-to-function, diseñados para aprender cómo se relaciona una secuencia de DNA y su actividad funcional, a partir de grandes volúmenes de datos ómicos y biomoleculares integrados. Su entrada es una región de hasta 1 Mb de DNA (un millón de pares de bases, bp), una escala lo suficientemente amplia como para tener en cuenta elementos reguladores situados a gran distancia del locus de interés. Para estudiar el efecto de una variante, el procedimiento consiste en comparar dos versiones del mismo locus, la secuencia de referencia y la secuencia alternativa portadora del alelo de interés. La diferencia entre ambas predicciones, el llamado REF/ALT analysis, transforma una alteración puntual del DNA en una hipótesis funcional cuantificable. Para manejar ventanas de entrada tan extensas, el modelo fragmenta y desplaza ligeramente la secuencia de DNA que analiza, de modo que una misma región genómica puede aparecer en posiciones distintas, de este modo, puede reconocer patrones biológicos relevantes sin depender de su localización y las procesa en paralelo (Figura 1). A partir de ahí construye representaciones lineales, adecuadas para describir señales distribuidas a lo largo del genoma, y otras bidimensionales, orientadas a capturar contactos entre regiones distantes. Sobre estas representaciones opera una arquitectura que combina tres componentes principales encadenados. En primer lugar, el «codificador» utiliza las capas convolucionales para detectar patrones locales de la secuencia, como motivos de unión de factores de transcripción, señales próximas a sitios de splicing y otros elementos cortos con relevancia reguladora. A continuación, los módulos «transformer» amplían el campo de visión del sistema y permiten modelar dependencias a larga distancia, por ejemplo, entre un elemento regulador distal y un promotor separado por miles de pares de bases. Finalmente, un «decodificador» inspirado en arquitecturas U-Net recupera información a distintas escalas, combinando el contexto global de la región analizada con los detalles finos de la secuencia local. A partir de estas representaciones, AlphaGenome despliega distintas cabezas de predicción, cada una especializada en un tipo de salida funcional. El modelo puede integrar señales de RNA-seq y 5’ mRNA-seq para cuantificar la expresión génica, perfiles de DNase-seq y ATAC-seq para estimar accesibilidad cromatínica, datos de ChIP-seq para histonas y Factores de Transcripción (TFs, por sus siglas en inglés) para caracterizar el estado regulador de la región, y mapas de contacto cromatínico para inferir la organización tridimensional de los distintos loci. La idea central es que todas estas predicciones se generan desde una única secuencia de entrada y mediante un modelo compartido. Así, AlphaGenome ofrece una visión conjunta, más cercana a un paisaje biológico completo que a una suma de predicciones aisladas, logrando una visión genómica global.
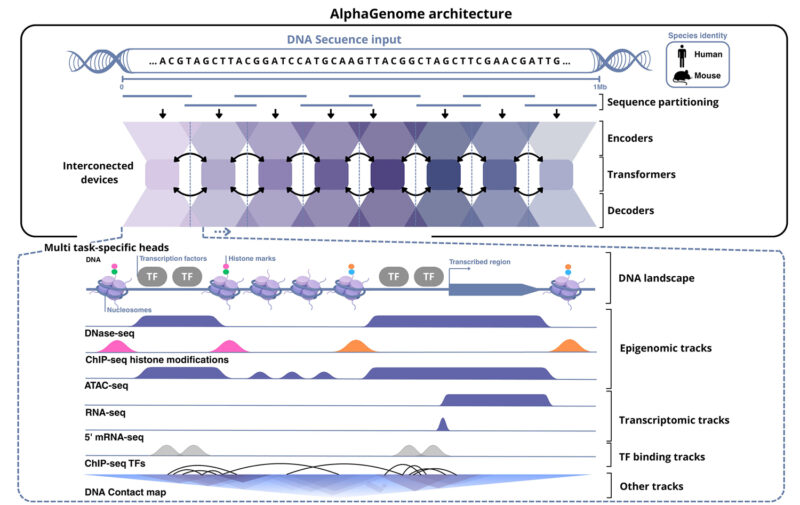
Esquema general de la arquitectura de AlphaGenome para la predicción funcional biomolecular a partir de la secuencia genómica. El algoritmo parte del procesamiento de la secuencia de DNA (DNA Sequence input) para lograr la predicción multimodal de señales funcionales mediante combinación e integración de miles de datos e información biomolecular en múltiples capas (multiple tracks) de modo progresivo y comparativo a lo largo de la secuencia de DNA. (Figura original diseñada por los autores, basada en Avsec et al. Nature, 2026).
Aplicando la nueva IA generativa a la genómica: un trabajo de los últimos cinco años
El origen de AlphaGenome no ha sido repentino, ya que dentro del equipo de DeepMind dirigido por Pushmeet Kohli y Žiga Avsec empezaron a trabajar hace más de cinco años en este proyecto en colaboración con el equipo de David R. Kelley de la empresa Calico Life Sciences (San Francisco, California). Así, en 2021 presentaron una primera herramienta llamada «Enformer», diseñada para predecir de modo efectivo la expresión génica a partir de la secuencia del DNA usando la arquitectura de «transformers» y redes neuronales convolucionales profundas (Deep Convolutional Neural Networks, CNNs por sus siglas en inglés)3. Su objetivo era predecir diferentes pistas genómicas a partir del procesamiento de secuencias de DNA de hasta 200 Kb. Este modelo concibe el genoma como una colección de miles de señales bioquímicas y biomoleculares independientes que se activan y controlan desde la secuencia genómica con muchos efectos de larga distancia, es decir, con interacciones entre regiones de la secuencia que no tienen por qué estar contiguas. En esta línea, el equipo de Calico Life Sciences LLC, liderado por Johannes Linder y David R. Kelley4, siguió trabajando y publicó en 2025 una segunda herramienta llamada «Borzoi». Esta adopta la arquitectura de «Enformer», pero amplía hasta 500 Kb el tamaño de las secuencias de DNA que procesa. Este modelo concibe el genoma de una manera más funcional e integrada, tratando de entender cómo la secuencia dicta la forma final del RNA mensajero. Adopta un enfoque más holístico al integrar, en un solo proceso de modelado de perfiles de cobertura de RNA-seq, el inicio de la transcripción, el splicing y la terminación. Con el tiempo, ambos modelos se convirtieron en referentes dentro de la genómica predictiva. AlphaGenome nace precisamente de esa evolución: combina la capacidad multimodal de «Enformer» con la visión más integrada y funcional de «Borzoi». El resultado es un modelo capaz de analizar secuencias de DNA más largas y con un nivel de resolución nunca visto hasta ahora.
Accesibilidad y tecnología open-source al alcance de todos
Google DeepMind ha facilitado el acceso a AlphaGenome mediante una API en línea, un paquete de Python y herramientas disponibles en GitHub. Obtener la API es rápido y sencillo, por lo que el modelo puede incorporarse a flujos de análisis de variantes sin necesidad de entrenarlo desde cero ni disponer de una gran infraestructura computacional. Aun así, esta accesibilidad no debe confundirse con la validación biológica y menos con la validación clínica. Los resultados de AlphaGenome son predicciones que requieren interpretación experta, contraste con datos independientes y, siempre que sea posible, confirmación experimental.
Ventajas, desventajas y limitaciones
La principal fortaleza de AlphaGenome reside en su capacidad para integrar capas de información molecular muy distinta a partir de una única secuencia de DNA. En lugar de limitarse a predecir un único efecto, el modelo permite examinar el posible efecto de una variante en distintos niveles de regulación y valorar si esos cambios apuntan hacia un mecanismo biológico coherente. Sin embargo, esta capacidad no elimina las limitaciones propias de un modelo entrenado a partir de datos existentes. Aunque trabaja con ventanas de hasta 1 Mb, capturar con precisión la influencia de elementos reguladores muy distales sigue siendo difícil. La regulación génica no siempre ocurre dentro de distancias sencillas de interpretar y quizás todavía hoy desconocemos ciertos tipos de regulaciones y controles inscritos en las regiones no codificantes del DNA. Otra dificultad importante es la dependencia del contexto biológico. Un mismo cambio en la secuencia puede tener consecuencias diferentes según el tejido, el estado de diferenciación celular o las condiciones moleculares en las que se encuentre la célula. La regulación del genoma no es un proceso fijo ni lineal. AlphaGenome puede aproximarse a muchos patrones reguladores, pero no puede reproducir por completo la complejidad de un sistema vivo. Además, el rendimiento del modelo está condicionado por los datos con los que ha sido entrenado y evaluado. AlphaGenome predice mejor aquellos genes, tejidos y mecanismos que han sido estudiados con mayor profundidad. Su razonamiento está condicionado por el mapa incompleto que la ciencia ha construido hasta ahora. Esta herramienta todavía presenta limitaciones en la representación de genes no codificantes, genomas personales y procesos biológicos complejos que van más allá de los efectos directos de una variante. AlphaGenome, debe entenderse, por tanto, como una herramienta de apoyo a la investigación, no como una prueba diagnóstica ni como sustituto de la validación experimental. Sus resultados son hipótesis computacionales que sólo adquieren pleno valor cuando se interpretan con rigor biológico y se contrastan con evidencias independientes.
Hacia un estudio integral del genoma asistido por IA
Lo que sí parece evidente es que la IA va a desempeñar un papel central en el futuro de las ciencias biológicas y biomoleculares. La cuestión ya no es si estas herramientas van a transformar la investigación, sino cómo decidimos posicionarnos frente a ellas, es decir, contribuir activamente a ese avance o limitarnos a ser meros espectadores. Todo esto también deja una reflexión importante sobre la propia forma en la que hacemos ciencia. Tanto AlphaFold como AlphaGenome ponen de manifiesto las limitaciones inherentes al conocimiento humano: tendemos a investigar aquello que ya conocemos, mientras que lo desconocido suele quedar relegado o infravalorado. Durante años, regiones enteras del genoma fueron catalogadas como «DNA basura», una denominación que hoy resulta cada vez más cuestionable. No porque ahora entendamos completamente su función, sino precisamente porque hemos comprobado hasta qué punto nuestra ignorancia condiciona nuestras interpretaciones. Curiosamente, a estos modelos tan avanzados y expertos de IA les pasa lo mismo, que lo que no conocen o no han visto en los miles de millones de datos que analizan, no son capaces de descubrirlo. Un ejemplo de esta limitación ha sido recientemente publicado en una comparativa de la capacidad de descubrir nuevas interacciones moleculares entre proteínas por métodos ómicos experimentales frente a lo que es capaz de descubrir la IA con AlphaFold aplicado a esta cuestión5.
Referencias
- Avsec Ž, et al. Advancing regulatory variant effect prediction with AlphaGenome. Nature 649 (2026) 1206-1218. https://doi.org/10.1038/s41586-025-10014-0
- Jumper J, et al. Highly accurate protein structure prediction with AlphaFold. Nature 596 (2021) 583-589. https://doi.org/10.1038/s41586-021-03819-2
- Avsec Ž, et al. Effective gene expression prediction from sequence by integrating long-range interactions. Nature Methods 18 (2021) 1196-1203. https://doi.org/10.1038/s41592-021-01252-x
- Linder J, et al. Predicting RNA-seq coverage from DNA sequence as a unifying model of gene regulation. Nature Genetics 57 (2025) 949-961. https://doi.org/10.1038/s41588-024-02053-6
- Lambourne L, et al. Experimental assessment of AI-based interactome mapping. Nature Communications 17 (2026) 4894. https://doi.org/10.1038/s41467-026-70942-x